公開日: 2026.07.09 / 最終更新日: 2026.10.21
非構造化データの構造化とは|AIで活かせないデータを整える方法
非構造化データの構造化とは、文書・PDF・メール・レビューなどに埋もれた情報を項目ごとにそろえ、AIやシステムが扱える形にすることです。そのままではAIが使えない理由、項目定義から抽出・検証までの方法、外注費用の目安を解説します。
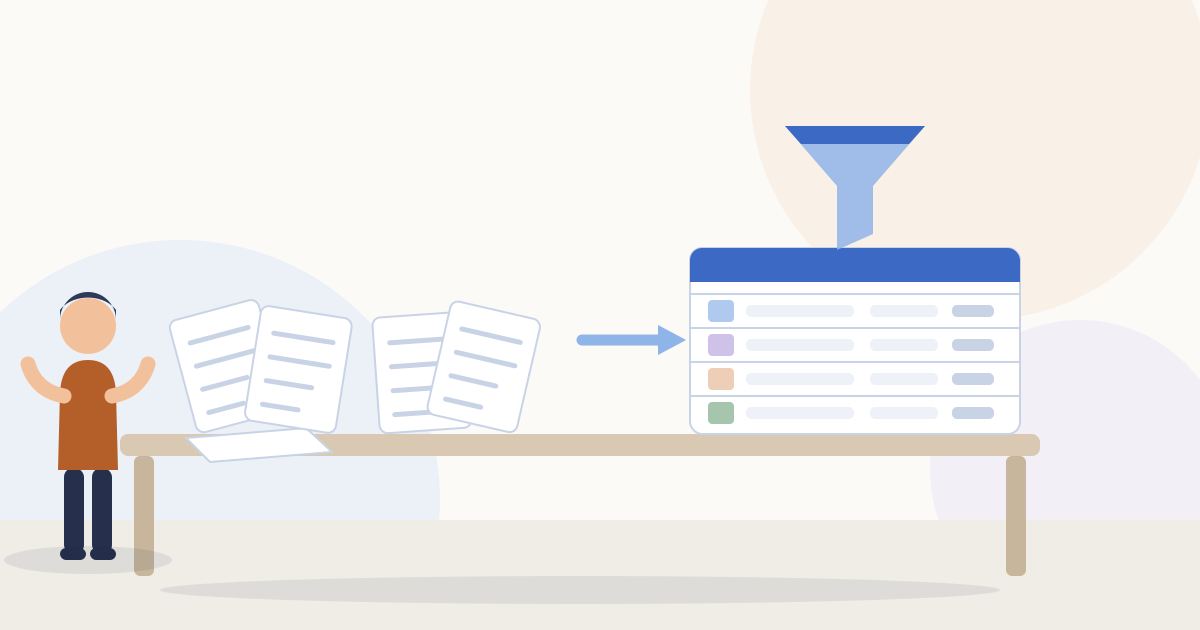
非構造化データの構造化とは、文書・PDF・メール・商品説明文・顧客レビューなどに文章のまま埋もれた情報を、「誰の・いつの・何についての・どういう値か」という項目ごとに取り出し、表の形にそろえることです。進め方は、目的を決める、項目を定義する、OCRやLLMで項目を抜き出す、表記ゆれをそろえる、抜き取りで精度を確かめる、の順になります。
過去の資料が山ほどあるのに、AIに使わせるとうまくいかないことがあります。この場合、原因はAIの性能よりデータの持ち方にあります。社内のデータの大半は、項目に分かれていない文章や画像のまま、複数の場所に散らばっています。
社内データの大半は「非構造化データ」
社内のデータは、大きく2種類に分けられます。
- 構造化データ:表計算ソフトの表のように行と列でそろい、集計・検索がしやすいデータ(売上表、顧客リストなど)
- 非構造化データ:決まった型を持たないデータ。文書ファイル、PDF、メール本文、商品説明文、顧客レビュー、問い合わせ履歴、紙をスキャンした画像など
業務で価値のある情報ほど、非構造化データの側にたまっています。「あの取引先とのやり取りの経緯」「商品の細かな仕様や注意点」「顧客がレビューに書いた不満」は、Excelの表になっておらず、文章や画像の中に埋もれています。AIに「うちのデータを分析して」と頼んでもうまくいかないのは、この埋もれたデータをそのまま渡しているからです。
なぜ、そのままではAIが使えないのか
LLM(大規模言語モデル。ChatGPTに代表される、文章を理解・生成できるAI)は文章を読むのが得意です。それなら非構造化データもそのまま渡せばよいと考えがちですが、業務で使うと次の壁にぶつかります。
- 情報が複数のファイル・形式にまたがっていて、AIが「どこを見ればいいか」を判断できない
- 同じ意味の項目が資料ごとに違う言葉で書かれていて(例:「納期」「お届け予定」「リードタイム」)、集計や比較ができない
- PDFや画像の中の文字は、そのままではデータとして取り出せない
- 根拠のない内容を、それらしく言い切ってしまう(ハルシネーション。AIが事実にない情報を自信ありげに生成する現象)
AIに正確に働いてもらうには、その手前で、AIが迷わず読める形にデータを整える必要があります。この整える工程が「構造化」です。
構造化とは:バラバラの情報を、AIが扱える形に整えること
構造化では、文章や画像に埋もれた情報を意味の軸で並べ直し、AIやシステムが扱える形にそろえます。商品カタログなら「素材・産地・サイズ・用途・対象顧客」、問い合わせ履歴なら「顧客・日時・種類・対応状況」といった軸に、情報を当てはめていきます。
この土台が整うと、AIで次のことができるようになります。
- 大量の資料の中から、質問に根拠つきで答える社内AI検索(RAG。手元のデータをAIに参照させて回答させる仕組み)が作れる
- 「用途」「悩み」「条件」といった切り口で、顧客が探している商品や情報にたどり着けるようになる
- レビューや問い合わせを分類・集計し、顧客の声を数字として経営判断に使える
蓄積した顧客レビューを分類・集計して経営判断に使う進め方は、顧客レビューをAIで分析する方法|できること・費用相場・始め方に具体例があります。
この工程を飛ばして「とりあえずAIを入れる」と、それらしい答えは出るものの信用できない状態が続きます。成果の差は、生成AIの性能より、手前のデータ整備で生まれます。
非構造化データを構造化する5つのステップ
- 目的を決める:構造化したデータで何をするか(社内検索・集計・ECの商品情報の充実など)を1つ選ぶ
- 項目を定義する:目的に必要な項目と、各項目の書き方(日付の形式、単位、選択肢)を表にする
- 項目を抜き出す:紙やPDFはOCR(画像の文字を読み取る技術)でテキストにし、LLMに項目の定義を渡して、決めた形式で値を出力させる
- 表記をそろえる:「納期」「お届け予定」のような同義語や単位の違いを、辞書を作って1つの表記に統一する
- 抜き取りで確かめる:抽出結果の一部を人が原文と照合し、誤りの傾向を項目の定義やプロンプトに反映する
たとえば問い合わせメールなら、本文から「顧客名・受付日・問い合わせの種類(不具合/納期/返品など)・対象商品・対応状況」の5項目を抜き出して表にします。種類の選択肢を前もって決めて、LLMにその中から選ばせると、集計できる形でそろいます。
外注する場合の費用感(目安)
非構造化データの構造化とAI活用を外注する費用は、対象データの量・散らばり具合・目指すゴールによって変わります。以下は市場の目安で、特定サービスの確定価格ではありません。
| 工程 | 費用の目安 | 中身 |
|---|---|---|
| 現状把握・設計 | 数十万円前後(無償で行う会社もある) | 対象データの棚卸し、構造化する項目の定義、投資対効果の試算 |
| データ前処理(読み取り・整形・分割) | 総額の3〜5割を占めることが多い | 形式の混在度と量に比例。スキャン画像や表を含む文書ほど高い |
| 活用の実装(検索・自動化・連携) | 小規模で500万〜1,000万円、規模により数千万円 | 検索基盤、業務システムとの連携、画面の作り込み |
| 保守・運用 | 月額10万〜30万円、または年間で開発費の10〜20% | 新規データの反映、精度の維持、項目定義の見直し |
費用が変動する主な要因は次の3つです。
- データの量と形式:文書・Excel・PDF・画像などが混在するほど、整える工数が増える
- 目指すゴールの深さ:「資料をAIで検索できるようにする」までか、「業務システムと連携して自動化する」までかで設計が変わる
- 既存システムとの連携:社内の基幹システムやECサイトへ反映する場合は、追加の実装が要る
小さく始めたい場合は、対象を1種類の文書に絞ってください。全社のデータをまとめて対象にすると、前処理の工数で見積もりが膨らみます。初期費用に加えて、運用を誰が続けるのかまで含めて見積もりを取ると、稼働後の費用の見落としを防げます。
構造化を進める4つのフェーズ
外注する場合も社内で進める場合も、プロジェクトは次の4つのフェーズに分かれます。
- 現状把握(2〜3週間程度):対象データの種類・量・散らばり具合を棚卸しし、どこまで構造化すればゴールに届くかを設計する
- PoC(概念実証。小規模に試して効果を確かめる工程):代表的なデータの一部で構造化のルールと抽出精度を検証し、本実装に進むかを判断する
- 実装:全データへの適用と、社内AI検索・既存システムへの反映を行う。期間はデータ量と連携範囲で変わる
- 運用・保守:新しく増えるデータや表記ゆれに合わせて項目の定義を見直し、精度を保つ
構造化でよくある3つの失敗
- ゴールを決めずに着手する:「とりあえず全データを整える」から始めると工数が膨らみ、どこまで整えれば十分かの判断がつかない。何ができるようになれば成功かを最初に決める
- 表記ゆれ・粒度の統一を後回しにする:「納期」「お届け予定」「リードタイム」のような同義語のばらつきを放置したまま進めると、後で集計・検索の精度が落ちる
- 精度の検証を省いて本番に出す:LLMによる自動抽出は完璧ではなく、誤った抽出(ハルシネーションを含む)が一定の割合で出る。抜き取り検証を挟まないと、誤ったデータが検索結果や自動処理に紛れ込む
ECサイトの商品情報が対象なら、構造化した項目は商品説明文のAI自動生成|EC向けの進め方・精度の上げ方・費用の材料にそのまま使えます。社内で進めるか委託するかは、AI受託開発は内製か外注か|判断基準と委託先を見極める3条件の判断軸で決められます。構造化したデータを社内検索に使う場合の費用の内訳は、RAG構築を外注する費用相場に詳しく書きました。
構造化すべきデータの種類や効果の出方は、業種によって異なります。業種ごとの特徴を踏まえた業種別の試算例(モデルケース)も参考にしてください。
対象がECサイトの商品情報であれば、awaiは項目の定義と既存の説明文からの抜き出しを行い、整えたデータを商品ページや絞り込み検索に反映するところまで受け持ちます。
自社ECの「作り方」も「伸ばし方」も、30分の無料相談で一緒に整理します作り方・予算のかけ方・マーケの知見・広告運用のうち、どれか一つが欠けていても、良い商品は売上につながりません。現状のEC・SNS・顧客データをうかがい、どこから伴走を始めるべきかをその場でご案内します。よくある質問
- Q. 非構造化データの構造化を外注する費用相場はどれくらいですか?
- A. 対象データの量・散らばり具合・目指すゴールによって変わります。市場の目安として、現状把握・設計で数十万円前後(無償で行う会社もあります)、活用の実装は小規模で500万〜1,000万円、規模により数千万円、保守は月額10万〜30万円または年間で開発費の10〜20%という水準です。データの前処理が総額の3〜5割を占めることが多いため、見積書に前処理の工数が計上されているかを確認してください。
- Q. PoC(概念実証)は必ず必要ですか?
- A. 必須ではありませんが、データ量が多い場合や抽出精度に不安がある場合は有効です。代表的なデータの一部で構造化のルールと精度を検証してから本実装に進めば、想定した精度が出ないまま大きな開発費をかけるリスクを減らせます。
- Q. 構造化と社内AI検索(RAG)はどう関係しますか?
- A. RAG(手元のデータをAIに参照させて回答させる仕組み)が根拠つきで正確に答えるには、参照元のデータが検索・照合できる形に整っている必要があります。構造化は、RAGの精度を左右する土台の工程です。
- Q. どんな形式のデータでも構造化できますか?
- A. 文書・PDF・Excel・画像スキャンなど、多くの形式に対応できます。ただし画像内の文字を読み取るOCR処理が必要な場合や、業務知識がないと意味が読み取れないデータは、項目の定義に追加の工数がかかります。現状把握のフェーズで対象データを確認してから見積もるのが通常です。
関連記事
- 2026.07.13顧客レビューをAIで分析する方法|できること・費用相場・始め方顧客レビューや口コミをAI(LLM)で分析すると何がわかるのかを整理し、スプレッドシート+LLM・SaaS・個別開発の3つの進め方と費用相場、100件から試せる最小構成の手順まで解説します。読む
- 2026.07.14AIエージェントとは|できることと業務活用の始め方・費用の目安AIエージェントとは、指示を理解して自分で判断し、社内システムを操作しながらタスクの完了まで進める生成AIです。できることや業務活用の具体例、導入の進め方と費用の目安を整理しました。読む
- 2026.07.14LangChainとは|できることと導入判断の考え方・費用の目安LangChainとは、生成AIを使ったアプリケーションを開発するためのオープンソースのフレームワークです。できること、AIエージェントやMCPとの関係、発注側が判断すること、内製・外注別の費用の目安を非エンジニア向けに示します。読む
- 2026.07.14生成AIのセキュリティ対策|企業が導入前に決める論点と費用の目安生成AIのセキュリティ対策を、入力データの扱い・出力内容の確認・権限設計の3点で説明します。社内ルールで決める項目、社外に出せないデータの扱い、開発会社への確認事項、対策ごとの費用の目安も載せています。読む